Load Average VPS Linux: Memahami Antrean Kerja, CPU, dan Waktu Pengamatan
Baca load average VPS Linux dengan konteks CPU, proses menunggu I/O, dan tiga rentang waktu agar tindak lanjut gangguan lebih tepat.
Tiga angka yang memerlukan konteks
Ketika website terasa lambat, pemilik VPS sering menerima tangkapan layar berisi tiga angka load average. Angkanya dapat terlihat tinggi tanpa penjelasan mengenai kapasitas, waktu pengamatan, dan pekerjaan yang sedang berjalan. Menafsirkan angka itu sendirian mudah menghasilkan keputusan yang salah arah. Pertanyaan yang lebih berguna adalah apakah beban berubah, bagaimana pengguna terdampak, dan bukti apa yang membantu pengelola menjelaskan keadaan tersebut.
Pembahasan ini berfokus pada Linux dan cara memakai load average sebagai petunjuk untuk pemeriksaan lanjutan. Contoh angka yang digunakan bersifat hipotetis, bukan hasil pengukuran server JagoWeb atau pelanggan tertentu. Tujuannya membantu pemilik situs berkomunikasi dengan pengelola teknis. Pembaca tidak diminta menghentikan proses atau mengubah pengaturan sistem hanya karena sebuah angka terlihat berbeda dari kebiasaan yang belum pernah dicatat sebelumnya.
Load average mencakup pekerjaan berjalan dan menunggu
Manual Linux menjelaskan bahwa load average mencakup pekerjaan dalam keadaan runnable serta uninterruptible, misalnya menunggu I/O disk. Runnable mencakup pekerjaan yang menggunakan CPU atau menunggu giliran CPU. Jadi, load average bukan persentase penggunaan CPU. Angka beban yang meningkat perlu ditelaah bersama pengukuran lain; melihatnya sebagai persentase akan menghilangkan perbedaan penting antara pekerjaan yang memerlukan CPU dan pekerjaan yang menunggu operasi lain.
Bagi pemilik website, perbedaan ini menentukan pertanyaan kepada pengelola. Jika keluhan berkaitan dengan lambatnya katalog dibuka, mintalah pemeriksaan yang menghubungkan beban sistem dengan kegiatan aplikasi saat itu. Jangan langsung menyimpulkan pembelian CPU tambahan merupakan satu-satunya jawaban. Keputusan kapasitas sebaiknya mengikuti penjelasan masalah yang teramati, termasuk apakah perubahan sumber daya memang akan menyasar kendala yang ditemukan oleh pemeriksaan teknis.
Baca urutan satu, lima, dan lima belas menit
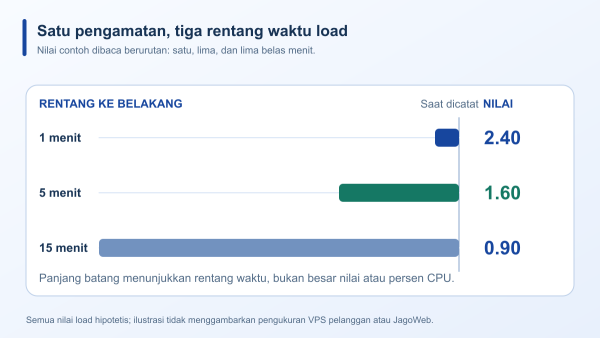
Perintah uptime menampilkan load average untuk rentang satu, lima, dan lima belas menit, berurutan dari kiri. Tiga angka tersebut menggambarkan beban dalam rentang waktu yang berbeda, bukan tiga jenis sumber daya. Misalnya, contoh 2.40, 1.60, dan 0.90 memperlihatkan nilai rentang pendek lebih besar daripada rentang panjang. Ini petunjuk untuk menelusuri perubahan beban, bukan bukti bahwa satu pekerjaan tertentu pasti menjadi penyebabnya.
Catat waktu pengambilan beserta zona waktunya agar angka dapat dicocokkan dengan laporan pengguna. Jika staf layanan melaporkan keluhan pada pagi hari, tangkapan layar yang diambil setelah makan siang tidak otomatis menjelaskan kondisi sebelumnya. Simpan beberapa pengamatan dengan konteks yang jelas dan bandingkan rentang yang sama. Hindari menggabungkan nilai pertama dari satu catatan dengan nilai ketiga dari catatan lain lalu menyebutnya sebagai ukuran yang setara.
Jumlah CPU membantu konteks, bukan mengubah angka menjadi persen
Manual uptime menyatakan load average tidak dinormalisasi terhadap jumlah CPU. Karena itu, angka yang sama perlu dibaca bersama kapasitas sistem tempat angka diambil. Mintalah pengelola menjelaskan CPU yang tersedia pada VPS dan lingkup pemantauannya. Namun, membagi load dengan jumlah CPU tidak serta-merta menghasilkan persentase penggunaan CPU, sebab jenis pekerjaan yang masuk dalam hitungan load juga perlu diperhitungkan dalam penafsiran.
Hindari menetapkan batas sehat universal berdasarkan satu angka yang ditemukan pada artikel atau tangkapan layar orang lain. Situs profil perusahaan dan aplikasi yang memproses banyak pekerjaan latar memiliki pola kegiatan berbeda. Tentukan terlebih dahulu kegiatan normal, jam sibuk, dan gejala yang perlu ditindaklanjuti. Perbandingan terhadap keadaan normal situs sendiri akan lebih berguna untuk diskusi operasional daripada meminjam ambang dari lingkungan yang rincian bebannya tidak diketahui.
Kenali sumber angka dan bagian lain pada /proc/loadavg
Manual proc_loadavg menjelaskan bahwa tiga kolom awal /proc/loadavg berisi angka load yang juga ditampilkan uptime. Kolom berikutnya memiliki dua angka yang dipisahkan garis miring: entitas penjadwalan yang saat itu runnable dan total entitas yang ada. Kolom terakhir adalah PID proses yang paling baru dibuat. Angka setelah garis miring bukan jumlah CPU atau persen penggunaan sistem, sehingga jangan menafsirkannya sebagai ukuran kapasitas.
Jika pengelola menyertakan keluaran mentah, minta penjelasan label sebelum mengambil keputusan. Catatan yang mencantumkan sumber metrik akan mengurangi salah baca ketika beberapa alat menampilkan informasi berbeda pada layar yang sama. Anda tidak perlu menyalin seluruh isi sistem ke laporan gangguan. Pilih informasi yang menjawab pertanyaan dan simpan rincian teknis melalui sarana yang sesuai dengan kebijakan pengelolaan, terutama bila laporan memuat nama proses atau informasi internal aplikasi.
Hubungkan angka dengan pekerjaan yang sedang berlangsung
Buat garis waktu sederhana berisi waktu keluhan, kegiatan terjadwal yang diketahui, serta perubahan aplikasi yang baru dilakukan. Sebagai contoh hipotetis, tim dapat mencatat bahwa pemrosesan gambar dimulai sebelum keluhan pelanggan muncul. Kedekatan waktu memberi alasan untuk memeriksa, tetapi belum membuktikan hubungan sebab akibat. Pengelola tetap perlu meninjau bukti proses dan sumber daya agar perbaikan tidak diarahkan hanya berdasarkan dugaan yang tampak masuk akal.
Pisahkan kejadian yang Anda ketahui dari penjelasan yang masih berupa kemungkinan. Laporan yang mengatakan keluhan muncul selama pemrosesan gambar lebih akurat daripada pernyataan pemrosesan gambar pasti merusak server. Bila beberapa pekerjaan berlangsung bersamaan, catat semuanya beserta penanggung jawabnya. Informasi ini membantu pengelola memilih pemeriksaan yang tepat dan menghindari perubahan terburu-buru yang mengganggu pekerjaan lain tanpa menyelesaikan keluhan yang sebenarnya.
Minta bukti pembanding yang menjawab dugaan
Setelah melihat pola load, minta pengelola menambahkan bukti pemakaian CPU, keadaan proses, serta kondisi I/O yang relevan. Pertanyaannya perlu spesifik: apakah pekerjaan sedang menunggu CPU, menunggu operasi penyimpanan, atau keluhan terjadi di bagian aplikasi yang berbeda? Jenis pemeriksaan disesuaikan oleh pengelola yang memahami sistem. Tidak semua angka pemantauan perlu dikumpulkan jika tidak membantu menguji penjelasan yang sedang dipertimbangkan oleh tim.
Sertakan pula gejala dari sisi pengguna, seperti halaman mana yang lambat dan apakah masalah muncul pada tindakan tertentu. Load sistem tidak menggantikan pemeriksaan pengalaman pengguna. Sebuah perbaikan yang menurunkan angka tetapi membiarkan pencarian produk tetap gagal belum menyelesaikan kebutuhan bisnis. Karena itu, tentukan hasil yang ingin dipulihkan sejak awal agar metrik dan pengujian aplikasi dapat dinilai sebagai bukti yang saling melengkapi.
Tinjau perubahan dengan pengamatan sebelum dan sesudah
Bila pengelola menyarankan penyesuaian aplikasi atau kapasitas, tulis alasan, penanggung jawab, dan bukti yang akan dipakai untuk menilai hasilnya. Hindari beberapa perubahan besar sekaligus ketika tujuannya memahami pengaruh satu tindakan. Perbandingan memerlukan keadaan yang masuk akal untuk disejajarkan, termasuk waktu, jumlah pekerjaan, dan bagian aplikasi yang diperiksa. Tanpa konteks tersebut, nilai yang turun setelah perubahan masih bisa memiliki penjelasan lain.
Sesudah tindakan dilakukan, ulangi pemeriksaan pada keluhan awal dan dokumentasikan metrik yang relevan. Bila situs kembali nyaman digunakan, pertahankan catatan yang membantu mengenali pola serupa di kemudian hari. Jika masalah tetap ada, gunakan hasil itu untuk memperbaiki dugaan, bukan untuk menambah perubahan secara acak. Proses ini membuat diskusi pemeliharaan lebih terarah karena setiap keputusan memiliki hubungan yang jelas dengan bukti dan kebutuhan pengguna.
Gunakan hasilnya untuk merencanakan layanan VPS
JagoWeb menyediakan informasi layanan cloud VPS di https://www.jagoweb.com/cloud-vps-murah dan pilihan produk melalui https://www.jagoweb.com/. Gunakan hasil pemantauan untuk membahas kebutuhan aplikasi, kapasitas, dan pembagian tugas pengelolaan sebelum memilih perubahan layanan. Jangan menganggap semua paket atau semua website memerlukan konfigurasi yang sama. Rekomendasi yang dapat ditinjau sebaiknya menyebut kebutuhan yang hendak dipenuhi dan bukti yang mendasarinya, bukan sekadar angka load tertinggi yang sempat terlihat.
Tetapkan kebiasaan mencatat kondisi normal dan cara menghubungi pengelola ketika keluhan muncul kembali. Catatan tidak perlu rumit: waktu, sumber metrik, tiga nilai load, konteks kapasitas, kegiatan yang diketahui, dan gejala pengguna sudah memberi awal yang lebih jelas. Pembacaan load average yang tepat membantu memulai diagnosis. Penyelesaian tetap bergantung pada pemeriksaan teknis yang sesuai serta verifikasi bahwa layanan yang diperlukan pengguna kembali berfungsi dengan baik.
Bacaan terkait
Sumber dan referensi